はじめに
Webアプリケーション開発では、最初に設計したデータベースの構造が、開発終了まで変わらないとは限りません。新しい機能の追加や仕様変更によって、テーブルやカラムの追加・変更・削除が必要になることがあります。
例えば、図書館システムでは、最初は書籍タイトルと著者名だけを管理していても、後から出版社や出版年、貸出状況などの項目を追加することが考えられます。
しかし、SQLAlchemyのモデルを修正しただけでは、既存のデータベースのテーブル構造は変更されません。また、以前学習したdb.create_all()も、既存テーブルの構造を更新する機能ではありません。Flask-SQLAlchemy Documentation (3.1.x)
この問題を解決する技術が、**データベースマイグレーション(Database Migration)**です。
Flaskでは、Flask-Migrateという拡張ライブラリを使用することで、SQLAlchemyのモデル変更をもとにデータベース構造の変更履歴を管理できます。
今回は「図書館システム」を例に、マイグレーションを利用するメリットと利用しない場合の違い、Flask-Migrateの初期設定、スキーマ変更の実行方法、安全な運用方法、BlueprintやSQLAlchemyとの関係について学習します。
1. データベースマイグレーションとは
データベースマイグレーションとは、データベースのテーブル構造(スキーマ)の変更を、履歴として記録・管理する仕組みです。例えば、図書館システムのbooksテーブルが、開発の進行に合わせて次のように変化するとします。
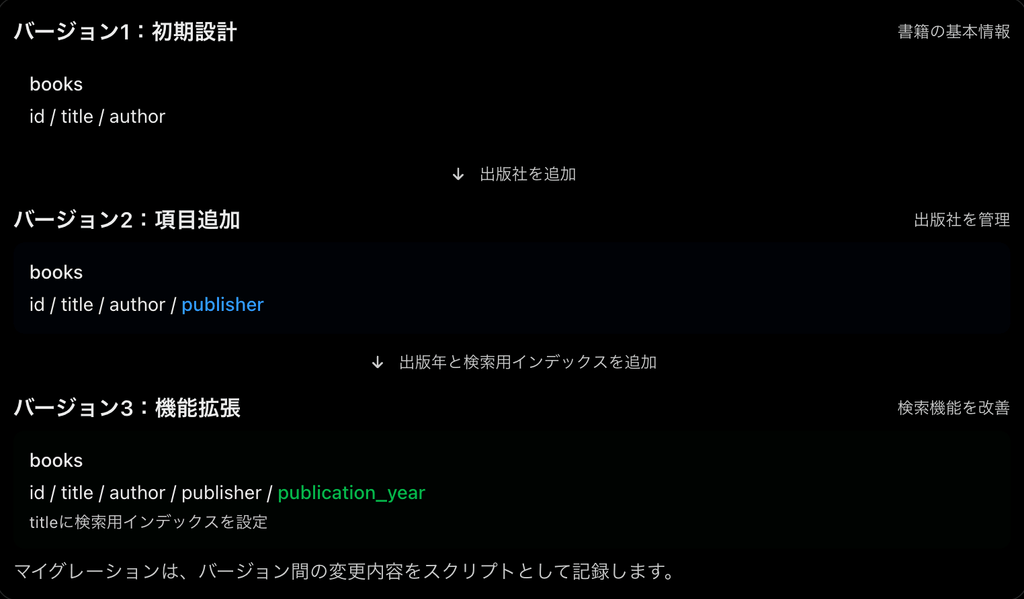
マイグレーションは、バージョン間の変更内容をスクリプトとして記録します。この例では、バージョン1からバージョン3までの変更を順番に管理します。重要なのは、既存のデータを可能な限り維持しながら、テーブル構造を変更できることです。
また、どのバージョンで何を変更したのかを記録できるため、開発環境と本番環境のデータベース構造を統一しやすくなります。なお、マイグレーションはデータのバックアップとは異なります。変更履歴を管理する仕組みであり、失われたデータを自動復元するものではありません。
2. Flask-Migrateを利用するメリット
Flask-Migrateは、Flaskアプリケーション向けのデータベースマイグレーション管理ライブラリです。内部では、SQLAlchemyのデータベースマイグレーションツールであるAlembicを使用しています。
Flask-Migrateを利用しない場合でも、SQLのALTER TABLEなどを直接実行することでスキーマ変更は可能です。それぞれの違いを比較します。
| 比較項目 | Flask-Migrateなし | Flask-Migrateあり |
|---|---|---|
| テーブル変更 | ALTER TABLEなどを手動実行 | 変更スクリプトを生成・適用 |
| 変更履歴 | 自分で記録する必要がある | リビジョンとして管理 |
| モデルとの比較 | 手動で確認 | 変更候補を自動検出 |
| 環境間の同期 | SQLを個別に実行 | 同じ履歴を順番に適用 |
| 以前の構造に戻す | 逆操作を自分で準備 | downgradeスクリプトを使用 |
| チーム開発 | 変更内容の共有が煩雑 | Gitなどで履歴を共有 |
| 導入の手間 | 追加ライブラリ不要 | 初期設定が必要 |
| 変更の安全性 | 手動設計と検証が必要 | 生成内容の確認と検証が必要 |
メリット① テーブル変更の履歴を管理できる
SQLを直接使用する場合は、どのSQLをいつ実行したのかを自分で管理する必要があります。一方、Flask-Migrateでは変更内容をPythonのマイグレーションスクリプトとして保存します。そのため、書籍テーブルに出版社を追加した履歴や、検索用インデックスを追加した履歴などを後から確認できます。
メリット② SQLAlchemyのモデル変更を検出できる
例えば、既存のBookモデルに次のカラムを追加したとします。
publisher = db.Column(db.String(100), nullable=True)Flask-Migrateを使用すると、モデルとデータベースの構造を比較し、必要な変更を含むスクリプトの候補を生成できます。ただし、すべての変更を正確に検出できるわけではありません。カラム名の変更や一部の制約変更などは、手動で調整する必要があります。Alembic 1.19.2 documentation
メリット③ 開発環境と本番環境を同期しやすい
例えば、開発者が書籍テーブルに新しいカラムを追加した場合、その変更を本番環境にも反映しなければなりません。Flask-Migrateでは、同じマイグレーションスクリプトを各環境に適用できます。これにより、手動でSQLを実行する場合と比べて、変更漏れや環境ごとの構造の不一致を防ぎやすくなります。
メリット④ 変更前の状態に戻す手段を用意できる
Flask-Migrateでは、データベース構造を更新するupgrade()と、以前の構造に戻すdowngrade()を定義できます。ただし、downgradeはバックアップからの復元ではありません。
例えば、出版社のカラムを削除する処理を実行した場合、そのカラムに保存されていたデータは失われる可能性があります。そのため、マイグレーションを戻せることと、データを完全に復元できることは区別する必要があります。
3. Flask-Migrateを使用しない場合との違い
図書館システムのbooksテーブルに、出版社を保存するpublisherカラムを追加する場合を比較します。
パターンA:SQLを直接実行する方法
SQLAlchemyのモデルを変更した後、データベースに対して次のSQLを実行します。
ALTER TABLE books
ADD COLUMN publisher VARCHAR(100);
この方法では、SQL文を自分で作成して実行する必要があります。単純なカラム追加であれば問題ありませんが、複数のカラム変更や制約の追加、データ変換などが必要になると管理が複雑になりやすくなります。また、変更履歴を管理する仕組みがない場合、すでに適用したSQLを誤って再実行してしまう可能性もあります。
パターンB:Flask-Migrateを使用する方法
まず、SQLAlchemyのモデルを変更します。
publisher = db.Column(db.String(100), nullable=True)続いて、次のコマンドを実行します。
python -m flask --app run db migrate -m "Add publisher to books"このコマンドはモデルとデータベースを比較し、変更内容を含むマイグレーションスクリプトを生成します。その内容を確認した後、次のコマンドで適用します。
python -m flask --app run db upgradeこのようにFlask-Migrateでは、モデルの変更内容をもとにスキーマ変更を管理できます。ただし、Flask-Migrateが自動生成するスクリプトはあくまで変更候補です。実行前に内容を確認する必要があります。
4. Flaskアプリケーションの構造
前回学習したSQLAlchemyの構成に、Flask-Migrateを追加します。
図書館システムのディレクトリ構成例

library_app/
├── run.py                  # Flaskアプリケーションの起動
├── app/
│   ├── __init__.py         # Flask・SQLAlchemy・Migrateの連携
│   ├── extensions.py       # SQLAlchemy・Migrateの定義
│   ├── models.py           # 書籍テーブルなどのモデル定義
│   ├── routes.py           # Blueprint・ビュー関数
│   └── forms.py            # 入力項目・バリデーション
├── templates/
│   ├── books.html          # 書籍一覧画面
│   └── book_create.html    # 書籍登録画面
├── migrations/             # データベース変更履歴
│   ├── versions/           # 各バージョンの変更スクリプト
│   ├── env.py              # Alembicの実行環境設定
│   └── alembic.ini         # マイグレーション設定
└── instance/ # SQLiteファイルの保存先マイグレーションを導入しても、Blueprintやforms.py、Jinja2の役割は基本的に変わりません。新しく追加されるのは、データベースの変更履歴を管理するmigrationsディレクトリと、Flask-Migrateの設定です。
各ファイルの役割
| ファイル | 主な役割 |
|---|---|
models.py | 現在のテーブル構造を定義する |
extensions.py | SQLAlchemy・Flask-Migrateを生成する |
__init__.py | Flaskアプリケーションへ各機能を登録する |
routes.py | データの検索・保存・画面遷移を制御する |
forms.py | 入力値の検証を行う |
| Jinja2 | データやフォームをHTMLとして表示する |
migrations/versions/ | スキーマ変更の履歴を保存する |
重要なのは、models.pyとmigrationsの違いです。models.pyは現在のテーブル構造を表し、migrationsはそこに至るまでの変更履歴を表します。
5. SQLAlchemy・Flask-Migrate・Blueprint・Jinja2の関係
前回のSQLAlchemyの記事では、フォームから入力された書籍情報をデータベースに保存する仕組みを学習しました。Flask-Migrateは、その通常のデータ処理とは別の役割を担当します。
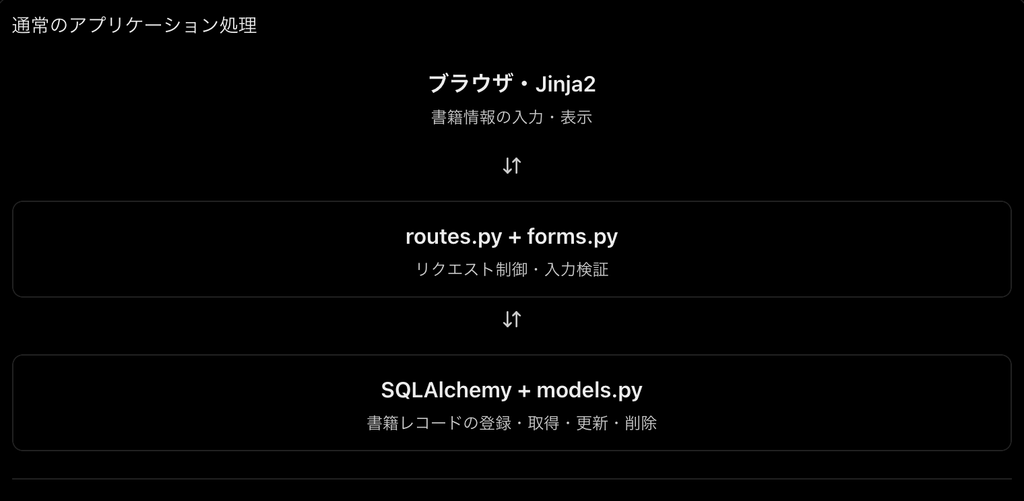
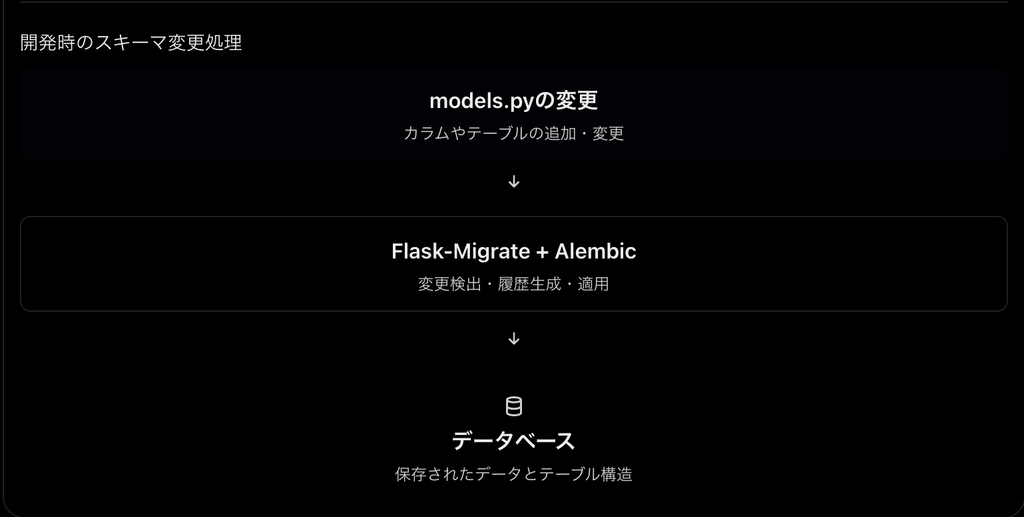
通常のアプリケーション処理では、SQLAlchemyを使用して書籍レコードを登録・更新します。一方、書籍テーブルに新しいカラムを追加する場合は、Flask-Migrateによってスキーマを変更します。
つまり、SQLAlchemyはデータベース内のデータ操作、Flask-Migrateはデータベース構造の変更管理を主に担当するという違いがあります。
Flask-Migrateは通常、ブラウザからのアクセスのたびに実行するものではありません。開発者や運用担当者が、必要なタイミングでコマンドを実行して管理します。
6. Flask-Migrateの初期設定
ここからは図書館システムにFlask-Migrateを導入する手順を説明します。前回の記事で作成したcreate_app()とSQLAlchemyを使用する構成を引き継ぎます。
① Flask-Migrateのインストール
仮想環境を有効にした状態で、次のコマンドを実行します。
python -m pip install Flask-MigrateFlask-Migrateは、内部でAlembicを使用します。Alembic(アレンビック)とは、SQLAlchemyで使用するデータベースの構造変更を管理するためのライブラリです。テーブルの追加やカラムの変更などを、マイグレーションスクリプトとして記録・実行できます。
Flaskでは、Alembicを内部で利用するFlask-Migrateを通じて操作するのが一般的です。なのでFlask-Migrateをインストールすれば依存ライブラリとしてAlembicもインストールされます。
② extensions.pyの修正
SQLAlchemyとFlask-Migrateのインスタンスを定義します。
app/extensions.py
from flask_sqlalchemy import SQLAlchemy
from flask_migrate import Migrate

db = SQLAlchemy()
migrate = Migrate()
この時点では、まだFlaskアプリケーションとは連携していません。アプリケーションの生成と拡張機能の初期化を分離することで、create_app()を使った構造を維持できます。
③ init.pyの修正
続いて、FlaskアプリケーションにFlask-Migrateを登録します。
app/init.py
import os
from flask import Flask
from .extensions import db, migrate

def create_app():
    app = Flask(__name__)

    app.config["SECRET_KEY"] = os.environ["SECRET_KEY"]
    app.config["SQLALCHEMY_DATABASE_URI"] = "sqlite:///library.db"

    # SQLAlchemyを登録
    db.init_app(app)

    # Flask-Migrateを登録
    migrate.init_app(app, db)

    # モデルを読み込む
    from . import models

    # Blueprintを登録
    from .routes import main
    app.register_blueprint(main)

    return app
特に重要なのは、次の処理です。
migrate.init_app(app, db)この処理によって、Flask-MigrateがFlaskアプリケーションとSQLAlchemyを認識できるようになります。
| 記述 | 役割 |
|---|---|
db.init_app(app) | SQLAlchemyをFlaskへ登録 |
migrate.init_app(app, db) | Flask-Migrateを登録 |
from . import models | モデル定義を読み込む |
app.register_blueprint(main) | Blueprintを登録 |
models.pyの読み込みが重要なのは、AlembicがSQLAlchemyのモデル定義を参照して変更を検出するためです。必要なモデルが読み込まれていないと、テーブルが認識されず、意図しないマイグレーションスクリプトが生成される可能性があります。
④ run.pyの確認
run.py
from app import create_app

app = create_app()

if __name__ == "__main__":
    app.run(debug=True)
run.pyは、create_app()を実行してFlaskアプリケーションを生成します。マイグレーションコマンドも、このアプリケーションの設定を利用します。なお、debug=Trueは学習環境のみで使用し、本番環境では無効にします。
7. マイグレーションの初期化
Flask-Migrateの設定が完了したら、マイグレーション管理用のディレクトリを作成します。プロジェクトのルートディレクトリで次のコマンドを実行します。
python -m flask --app run db initこのコマンドを実行すると、migrationsディレクトリが生成されます。代表的な構成は次のとおりです。
migrations/
├── versions/
├── alembic.ini
├── env.py
├── README
└── script.py.mako| ファイル・フォルダ | 役割 |
|---|---|
versions/ | マイグレーションスクリプトの保存先 |
env.py | Alembicの実行環境設定 |
alembic.ini | Alembicの設定 |
script.py.mako | スクリプトの生成テンプレート |
README | マイグレーション環境の説明 |
db initは、通常1つのプロジェクトで最初に1回だけ実行します。また、初期化しただけではデータベースのテーブル構造は変更されません。
初期マイグレーションの作成
ここでは、図書館システムのデータベースを新規作成する例を考えます。次のBookモデルが定義されているとします。
app/models.py
from .extensions import db

class Book(db.Model):
    __tablename__ = "books"

    id = db.Column(
        db.Integer,
        primary_key=True
    )

    title = db.Column(
        db.String(100),
        nullable=False
    )

    author = db.Column(
        db.String(100),
        nullable=False
    )
モデルを定義したら、次のコマンドを実行します。
python -m flask --app run db migrate -m "Initial books table"このコマンドを実行すると、通常は次の場所に自動生成されます。
studylog/
└── migrations/
    └── versions/
        └── xxxxx_initial_books_table.py
以下は生成されたスクリプト(xxxx_initial_books_table.py)ファイルの例です。
def upgrade():
    op.create_table(
        'books',
        sa.Column('id', sa.Integer(), nullable=False),
        sa.Column('title', sa.String(100), nullable=False),
        sa.PrimaryKeyConstraint('id')
    )

def downgrade():
op.drop_table('books')モデルとデータベースの構造を比較し、変更内容を含むマイグレーションスクリプトの候補を生成します。初期マイグレーションでは、booksテーブルを作成する処理が生成されます。次に、生成されたスクリプトを確認し、問題がなければ次のコマンドを実行します。
python -m flask --app run db upgradeこれにより、データベースにbooksテーブルが作成されます。
| コマンド | 役割 |
|---|---|
flask db migrate | DBの構造変更に必要なPythonスクリプトを生成する |
flask db upgrade | 生成されたスクリプトを実行し、実際のDB構造に反映する |
flask db downgrade | 変更を元に(upgrade前に)戻す処理 |
ポイント: migrateは変更手順を作成するだけで、データベースにはまだ反映しません。upgradeを実行して初めてテーブルが作成・変更されます。
注意: この初期手順は、まだテーブルが作られていない新規データベースを想定しています。すでにdb.create_all()などでテーブルを作成している場合、初期マイグレーションの作成方法が異なるため、後述する既存データベースの取り扱いを確認してください。
8. 実際のマイグレーション操作
次に、図書館システムで新しい要件が発生した場合を考えます。当初は書籍タイトルと著者名だけを保存していましたが、新しく出版社を管理することになったとします。この変更をFlask-Migrateで実施します。
① models.pyにカラムを追加する
まず、Bookモデルにpublisherを追加します。
app/models.py
from .extensions import db

class Book(db.Model):
    __tablename__ = "books"

    id = db.Column(
        db.Integer,
        primary_key=True
    )

    title = db.Column(
        db.String(100),
        nullable=False
    )

    author = db.Column(
        db.String(100),
        nullable=False
    )

    # 新しく追加するカラム
    publisher = db.Column(
        db.String(100),
        nullable=True
    )
この時点では、Python上のモデル定義だけが変更されています。データベースのbooksテーブルには、まだpublisherカラムは存在しません。
② マイグレーションスクリプトを生成する
次のコマンドを実行します。
python -m flask --app run db migrate -m "Add publisher to books"すると、migrations/versions/に変更を記録したPythonファイルが生成されます。例えば、次のようなスクリプトになります。
from alembic import op
import sqlalchemy as sa

def upgrade():
    with op.batch_alter_table("books") as batch_op:
        batch_op.add_column(
            sa.Column(
                "publisher",
                sa.String(length=100),
                nullable=True
            )
        )

def downgrade():
    with op.batch_alter_table("books") as batch_op:
        batch_op.drop_column("publisher")
説明用に、リビジョンIDなどの付加情報を省略しています。実際の自動生成ファイルは、利用環境やライブラリのバージョンによって異なります。
upgrade()とdowngrade()の違い
| 関数 | 役割 |
|---|---|
upgrade() | 新しいバージョンの構造へ変更する |
downgrade() | 指定された以前の構造へ戻す |
今回の例では、upgrade()がpublisherカラムを追加し、downgrade()がそのカラムを削除します。
また、batch_alter_table()は、SQLiteのテーブル変更の制約に対応するためにも使用されます。Flask-MigrateではSQLiteに対応したバッチモードが標準で有効になっています。Flask-Migrate documentation+1
③ 生成されたスクリプトを確認する
マイグレーションスクリプトは、自動生成されても必ず内容を確認する必要があります。例えば、今回の変更内容が次のとおりになっているか確認します。
- 対象テーブルが
booksであること - 追加カラムが
publisherであること - データ型が
String(100)であること nullable=Trueであること- 意図しないテーブル削除などが含まれていないこと
特にカラム削除やデータ型変更が含まれている場合は、既存データに影響する可能性があります。
④ マイグレーションを適用する
スクリプトの内容に問題がなければ、次のコマンドを実行します。
python -m flask --app run db upgradeこの処理によって、データベースのbooksテーブルにpublisherカラムが追加されます。
変更後のテーブルは次のようになります。
| id | title | author | publisher |
|---|---|---|---|
| 1 | Python入門 | 山田太郎 | NULL |
| 2 | SQL基礎 | 佐藤花子 | NULL |
| 3 | Flask実践 | 鈴木一郎 | NULL |
今回の例では、publisherをNULL許可で追加しているため、既存の書籍データでは出版社が未設定のままになります。既存のタイトルや著者名は、正常にマイグレーションが完了すればそのまま維持されます。
⑤ マイグレーションの状態を確認する
現在適用されているバージョンは、次のコマンドで確認できます。
python -m flask --app run db currentこれまでの履歴を表示するには、次のコマンドを使用します。
python -m flask --app run db historyまた、モデルとデータベースの間に未反映のスキーマ差分があるかを確認するには、次のコマンドを使用できます。
python -m flask --app run db checkこれらのコマンドを利用することで、マイグレーションの適用状態を把握できます。
9. マイグレーションのバージョン管理
Flask-Migrateでは、それぞれのマイグレーションにリビジョンIDが割り当てられます。
例えば、図書館システムの変更履歴は次のようになります。
- 初期マイグレーションRevision:
a1b2c3booksテーブルを作成 - 出版社カラムの追加Revision:
d4e5f6publisherカラムを追加 - 出版年カラムの追加Revision:
g7h8i9publication_yearカラムを追加
リビジョンIDは説明用の架空の値です。実際のIDは生成時に決まります。これらは適用順序を持つ履歴として管理されます。例えば、新しい環境で図書館システムを構築する際は、マイグレーション履歴を利用することで、必要なテーブル構造を順番に作成できます。
alembic_versionテーブルとは
Flask-Migrateを使用すると、データベースには通常、alembic_versionという管理用テーブルが作成されます。このテーブルには、現在適用されているマイグレーションのリビジョンが記録されます。注意点として、alembic_versionはすべての変更履歴を保存するテーブルではありません。
変更履歴そのものは、migrations/versions/内のスクリプトで管理されます。そのため、migrationsディレクトリはGitなどのバージョン管理システムで共有することが重要です。
10. スキーマ変更の種類と注意点
実際のアプリケーションでは、新しいカラムの追加だけでなく、さまざまなスキーマ変更が発生します。
| 変更内容 | 例 | 注意点 |
|---|---|---|
| カラム追加 | 出版社を追加 | NOT NULL制約に注意 |
| カラム削除 | 不要な分類項目を削除 | 既存データが失われる |
| カラム名変更 | authorをauthor_nameに変更 | 自動検出では削除・追加と判断されることがある |
| データ型変更 | 出版年を文字列から整数に変更 | 既存データの変換が必要 |
| 制約追加 | ISBNをUNIQUEにする | 重複データがあると失敗する |
| インデックス追加 | 書籍タイトルの検索を高速化 | DB容量や書き込み性能に影響 |
| テーブル追加 | 貸出履歴テーブルを追加 | 外部キーなどの設計が必要 |
① カラムの追加
書籍テーブルに出版年を追加する場合、次のように定義できます。
publication_year = db.Column(
    db.Integer,
    nullable=True
)NULLを許可しているため、既存データがあっても比較的追加しやすい構成です。一方、nullable=Falseを指定すると、すでに存在する書籍データに出版年が設定されていないため、マイグレーションが失敗する場合があります。
このような場合は、まずNULLを許可した状態でカラムを追加し、既存データを更新してからNOT NULL制約を適用する方法が考えられます。
② カラム名の変更
例えば、authorをauthor_nameへ変更する場合です。単純にモデルの属性名を変更してマイグレーションを生成すると、旧カラムの削除と新カラムの追加として認識される場合があります。
そのまま実行すると、既存の著者名が失われる可能性があります。このような変更は、生成されたスクリプトを手動で修正し、カラム名変更として処理する必要があります。
③ データ型の変更
例えば、出版年を文字列から整数型へ変更する場合を考えます。
変更前:
publication_year = db.Column(db.String(4))変更後:
publication_year = db.Column(db.Integer)既存のデータに"2025"が保存されている場合、整数の2025へ変換できる可能性があります。しかし、"不明"などの文字列が保存されている場合は、そのまま数値型に変更できないことがあります。この場合、事前にデータを検証・修正する処理が必要です。
④ インデックスの追加
書籍タイトルを頻繁に検索する場合、インデックスを追加することで検索処理の高速化が期待できます。
title = db.Column(
    db.String(100),
    nullable=False,
    index=True
)
ただし、インデックスを増やすと、データの登録・更新時の処理負荷やデータベースの使用容量が増える場合があります。必要な検索条件やデータ量に応じて設計することが重要です。
11. データ変換を伴うマイグレーション
マイグレーションでは、テーブル構造の変更と同時に、保存済みデータの変換が必要になる場合があります。例えば、書籍テーブルにcategoryカラムを追加し、既存のすべての書籍に「未分類」を設定する場合です。次の例では、カラム追加、既存データの更新、NOT NULL制約の適用を順番に行います。
from alembic import op
import sqlalchemy as sa

def upgrade():
    # 1. NULLを許可してカラムを追加
    with op.batch_alter_table("books") as batch_op:
        batch_op.add_column(
            sa.Column(
                "category",
                sa.String(length=50),
                nullable=True
            )
        )

    # 2. 既存データに値を設定
    connection = op.get_bind()

    connection.execute(
        sa.text(
            "UPDATE books "
            "SET category = :category "
            "WHERE category IS NULL"
        ),
        {"category": "未分類"}
    )

    # 3. NULL禁止へ変更
    with op.batch_alter_table("books") as batch_op:
        batch_op.alter_column(
            "category",
            existing_type=sa.String(length=50),
            nullable=False
        )


def downgrade():
    with op.batch_alter_table("books") as batch_op:
        batch_op.drop_column("category")
このコードでは、最初からNOT NULLを設定するのではなく、既存データに値を設定してから制約を追加しています。また、データ更新処理ではSQLAlchemyのsa.text()とパラメータを使用しています。
このように、Flask-Migrateでは単純なテーブル変更だけでなく、データ変換を伴う処理も記述できます。ただし、複雑な処理ではデータベースごとの制約やトランザクションの動作が異なる場合があるため、事前検証が必要です。
12. downgradeによるロールバック
Flask-Migrateでは、マイグレーションを以前のバージョンに戻すこともできます。直前のマイグレーションを戻す場合は、次のコマンドを使用します。
python -m flask --app run db downgrade特定のリビジョンまで戻す場合は、そのIDを指定します。
python -m flask --app run db downgrade <revision_id>ただし、ロールバックには注意が必要です。
例えば、出版社のカラムを削除するdowngrade()を実行すると、そのカラムに保存されているデータも失われる可能性があります。再度upgrade()を実行してカラムを作成しても、削除された値が自動的に復元されるわけではありません。
ロールバックとバックアップの違い
| 項目 | downgrade | バックアップから復元 |
|---|---|---|
| 主な目的 | スキーマを以前の状態に戻す | DBの状態を復元する |
| データ復元 | 保証されない | バックアップ時点の復元が可能 |
| 管理対象 | マイグレーション履歴 | データベース全体など |
| 主な利用場面 | スキーマ変更の取り消し | 障害・データ損失への対応 |
したがって、downgradeがあるからバックアップは不要という考え方は誤りです。特に本番環境では、ロールバックだけでなくバックアップからの復元手順も準備する必要があります。
13. 既存データベースへFlask-Migrateを導入する場合
ここまでの説明では、最初からFlask-Migrateを利用する構成を紹介しました。しかし、すでにSQLAlchemyのdb.create_all()によってテーブルを作成している場合もあります。例えば、図書館システムで次のような状況が考えられます。
- すでに
library.dbが存在する booksテーブルが作成されている- 書籍データが保存されている
- これからFlask-Migrateを導入したい
この場合、新規データベースと同じ手順をそのまま実行してよいとは限りません。
なぜ注意が必要なのか
Flask-Migrateは、モデル定義とデータベースの現在の構造を比較して変更を検出します。すでにテーブルが存在し、モデルと一致している場合、初回のmigrateでは新しい変更が検出されないことがあります。
また、既存データベースに対してテーブルを新規作成するマイグレーションを適用すると、テーブルがすでに存在するためエラーになる可能性があります。
既存DBに導入する際の基本方針
既存のデータベースに導入する場合は、次の順序で検討します。
- データベース全体のバックアップを取得する。
- 現在のSQLAlchemyモデルと実際のテーブル構造が一致しているか確認する。
- 初期マイグレーションをどのように管理するか決定する。
- 必要に応じて既存スキーマを基準とした初期リビジョンを用意する。
- 適切な場合に限り、
flask db stampなどで適用済みリビジョンを記録する。 - 以後の変更を
migrateとupgradeで管理する。
stampは、実際のスキーマ変更を実行せず、指定したリビジョンを適用済みとして記録するコマンドです。したがって、モデルと実DBが一致していない状態で安易に使用すると、マイグレーションの履歴と実際のテーブル構造が食い違う可能性があります。既存データベースへの導入では、まず現在の構造を正確に把握することが重要です。
14. Flask-Migrateとセキュリティ・安全な運用
Flask-Migrateはデータベースの変更履歴を管理するライブラリですが、導入するだけでデータベースの安全性が保証されるわけではありません。特に本番環境では、誤ったマイグレーションによるデータ消失やアプリケーション停止に注意する必要があります。
| 対策項目 | 目的 | 主な方法 |
|---|---|---|
| データバックアップ | データ消失への備え | DBのバックアップ取得 |
| 事前検証 | 変更による問題を発見 | テスト環境でupgrade |
| スクリプト確認 | 意図しない変更を防ぐ | upgrade・downgradeのレビュー |
| バージョン管理 | 変更履歴の共有・追跡 | Gitでmigrationsを管理 |
| アクセス権限 | 不正な変更を防ぐ | DBユーザーの権限分離 |
| 機密情報の保護 | 接続情報の漏えい防止 | 環境変数などで管理 |
| 障害復旧 | 問題発生時の対応 | 復元手順・ロールバック計画 |
① 本番環境への適用前にテストする
本番環境に直接マイグレーションを適用するのではなく、可能な限りテスト環境で検証します。特にカラム削除、データ型変更、外部キー追加などは、既存データの状態によって失敗する可能性があります。また、大規模なテーブルではスキーマ変更中にロックが発生したり、処理に時間がかかったりすることがあります。
② マイグレーションファイルをGitで管理する
migrationsディレクトリは、ソースコードと同様にGitで管理することが推奨されます。これにより、どのバージョンでデータベースの構造を変更したのか追跡できます。ただし、データベースのパスワードや個人情報、実際のバックアップデータなどをGitに登録しないように注意が必要です。
③ 開発環境と本番環境の差異を確認する
例えば、開発環境ではSQLite、本番環境ではPostgreSQLを使用する場合、データベースごとにスキーマ変更の動作が異なることがあります。SQLiteは一部のALTER TABLE操作に制約があるため、Alembicではテーブルを再作成してデータを移す方式が使われる場合があります。Alembic 1.20.1 documentation
そのため、可能な限り本番環境と同じデータベースで事前検証することが望まれます。
④ アプリケーションとの互換性に注意する
例えば、booksテーブルからauthorカラムを削除した場合、古いアプリケーションコードがまだそのカラムを参照しているとエラーになります。このような問題を避けるため、大きな変更では次のように段階的に進めることがあります。
- 新しいカラムを追加する。
- アプリケーションを新しいカラムにも対応させる。
- 既存データを移行する。
- 古いカラムを使わないことを確認する。
- 不要になったカラムを削除する。
この方法は、稼働中のアプリケーションへの影響を減らすためにも有効です。
15. Flask-Migrateの主なコマンド一覧
実際の開発で使用するコマンドを整理します。
以下はpython -m flask --app runでアプリケーションを指定する構成です。
コマンド(db以降) | 役割 |
|---|---|
init | マイグレーション環境の初期化 |
migrate -m "説明" | モデル変更からスクリプトを生成 |
upgrade | 最新のリビジョンまで適用 |
downgrade | 直前のリビジョンへ戻す |
current | 現在適用されているリビジョン |
history | リビジョン履歴を表示 |
heads | 最新のリビジョンを確認 |
check | 未反映のモデル差分を検査 |
revision -m "説明" | 空のリビジョンスクリプトを作成 |
stamp <revision> | スキーマ変更せずリビジョンを記録 |
例えば、変更履歴を確認するコマンドは次のとおりです。
python -m flask --app run db historyFlask-Migrateが提供するコマンドの詳細は、Flask-Migrate公式ドキュメントで確認できます。
16. 初学者はどの順序で学ぶべきか
マイグレーションを理解するには、先にSQLAlchemyの基本的な仕組みを理解しておくことが重要です。特に、モデルの変更と実際のデータベース構造の変更が別の処理であることを理解する必要があります。
| 学習段階 | 推奨する学習内容 |
|---|---|
| SQLの基礎 | CREATE TABLE・ALTER TABLE・DROP TABLE |
| SQLAlchemyの基本 | モデル定義・CRUD操作 |
| Flaskとの連携 | Blueprint・forms.py・models.py |
| マイグレーションの導入 | Flask-Migrateの初期設定 |
| 基本操作 | init・migrate・upgrade |
| 変更履歴の管理 | current・history・downgrade |
| 実践的な運用 | データ移行・バックアップ・本番適用 |
最初は、既存テーブルへのNULL許可カラムの追加など、比較的単純で安全性を確認しやすい変更から学習することをおすすめします。その後、カラム名変更、データ型変更、外部キー追加、既存データの移行などへ進むと、段階的に理解を深められます。
create_all()とFlask-Migrateはどちらを使用すべきか
最後に、これまで学習したdb.create_all()との違いを整理します。
| 項目 | db.create_all() | Flask-Migrate |
|---|---|---|
| 新規テーブル作成 | 可能 | 可能 |
| 既存テーブル変更 | 不可 | 可能 |
| 変更履歴の管理 | 不可 | 可能 |
| ロールバック | 不可 | スクリプトによって対応 |
| 学習用途 | 初期のDB学習に適する | 継続的なアプリ開発に適する |
| 本番での継続的なスキーマ管理 | 不向き | 適切な運用のもとで利用 |
db.create_all()は、モデルから新規テーブルを簡単に作成するための機能です。一方、Flask-Migrateは、アプリケーションの成長に合わせてテーブル構造を継続的に変更・管理するための仕組みです。継続的に開発するアプリケーションでは、Flask-Migrateによってスキーマ変更の履歴を管理する設計が適しています。
まとめ
今回は、Flaskにおけるデータベースマイグレーションの役割と、Flask-Migrateを使用したスキーマ変更の管理方法について学習しました。
データベースマイグレーションは、テーブルやカラムの追加・変更・削除を履歴として管理する仕組みです。Flask-Migrateを活用することで、SQLAlchemyのモデル変更をもとにマイグレーションスクリプトを生成し、既存データを維持しながらデータベースの構造を変更しやすくなります。
SQLAlchemyのmodels.pyは現在のテーブル構造を定義し、Flask-Migrateはその変更履歴を管理します。BlueprintやJinja2による通常のアプリケーション処理とは役割が異なり、主に開発・運用時のデータベース管理に使用します。
ただし、自動生成されたスクリプトは必ず内容を確認し、バックアップや事前検証を行うことが重要です。