はじめに
Webアプリケーション開発において、データの保存と管理は欠かせない要素です。例えば、図書館システムでは書籍情報や会員情報、貸出履歴などを継続的に保存し、必要に応じて検索・更新・削除する機能が求められます。
SQLを直接記述する方法でもデータベース操作は可能ですが、アプリケーションが大規模になると、SQL文や接続処理の管理が複雑になることがあります。この問題を解決する方法の一つが、ORM(Object-Relational Mapping) です。
FlaskはWebアプリケーションを構築するためのフレームワークですが、データベースを操作する専用のORM機能は標準で備えていません。そのため、SQLiteなどのデータベースを直接操作するか、SQLAlchemy「エスキューエル・アルケミー」のようなライブラリを導入する必要があります。
今回は「図書館システム」を例に、SQLAlchemyを利用するメリットと利用しない場合の違い、モデルの定義方法、CRUD操作、セキュリティ対策、BlueprintやJinja2との関係について学習します。
1. SQLAlchemy(エスキューエル・アルケミー)とは
SQLAlchemyは、Pythonからリレーショナルデータベースを操作するためのライブラリです。SQLAlchemyにはSQLを組み立てて実行するCore機能と、Pythonのクラスをデータベースのテーブルに対応づけるORM機能があります。
従来のSQLでは、次のようにSQL文を直接記述します。
SELECT * FROM books WHERE id = 1;SQLAlchemyのORMを使用すると、同じ検索をPythonのコードで表現できます。
book = db.session.get(Book, 1)このコードでは、BookというPythonクラスを通じてデータベース内の書籍情報を取得しています。
ORMの仕組み
ORMは「Object-Relational Mapping」の略称で、日本語ではオブジェクト関係マッピングと呼ばれます。
ORM(Object-Relational Mapping:オブジェクト関係マッピング)とは、オブジェクト指向プログラミング言語で扱う「データ(オブジェクト)」と、リレーショナルデータベース(RDB)の「テーブル」を自動で結びつけ、SQLを直接書かずにデータベースを操作できるようにする仕組み(またはその技術)です。
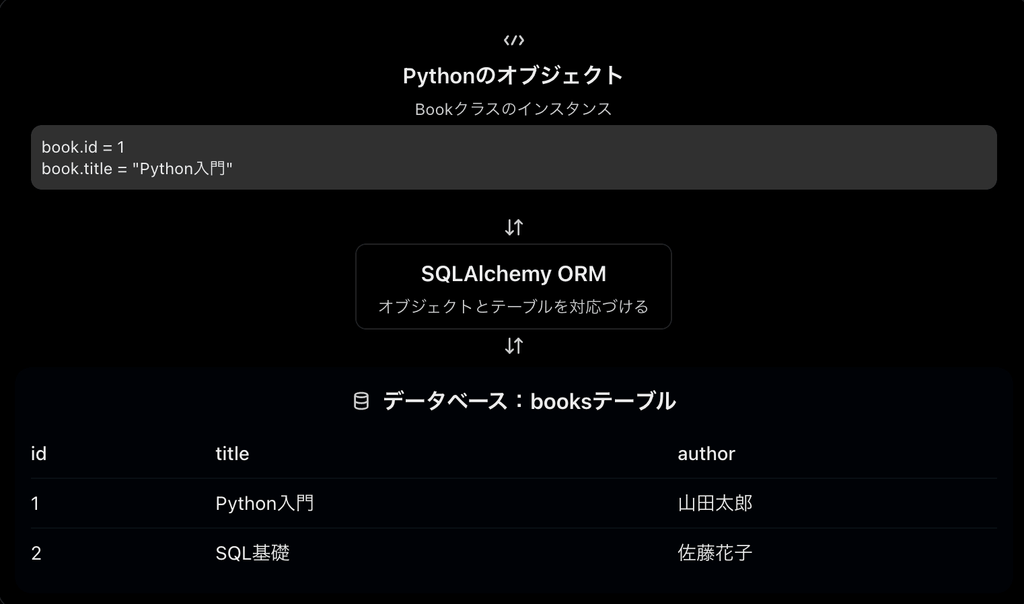
オブジェクトとテーブルを対応づける仕組みです。
データベース:booksテーブル
| id | title | author |
| 1 | Python入門 | 山田太郎 |
| 2 | SQL基礎 | 佐藤花子 |
Pythonではクラスやオブジェクトを操作し、SQLAlchemyがそれらをSQLやデータベースのレコードに対応づけます。これによって、開発者はSQLの細かな記述を減らし、Pythonのオブジェクト指向に近い方法でデータを扱えるようになります。
なお、SQLAlchemyを使用してもSQLそのものが不要になるわけではありません。テーブル設計やJOIN、制約、インデックスなどのSQLの知識は引き続き重要です。
2. SQLAlchemyを利用するメリット
SQLAlchemyを使用しない場合、Python標準ライブラリのsqlite3などを利用してSQL文を直接実行できます。
一方、SQLAlchemyを導入すると、SQL文の生成やオブジェクトへの変換、トランザクション管理などを共通の仕組みで扱いやすくなります。
| 比較項目 | SQLを直接使用 | SQLAlchemy ORM |
|---|---|---|
| データ操作 | SQL文を記述 | Pythonのクラス・メソッド |
| テーブル構造 | CREATE TABLEなどで定義 | モデルクラスで定義 |
| データの取得 | SQLの実行結果を受け取る | モデルのオブジェクトを取得 |
| SQLの記述量 | 多くなりやすい | 基本操作では少ない |
| データベース変更 | SQL方言の違いに対応 | 多くの基本操作を共通化 |
| SQLインジェクション対策 | プレースホルダーなどを適切に使用 | ORMの標準的なクエリ構築で対応しやすい |
| トランザクション | 接続・commit・rollbackを管理 | Sessionで管理 |
| 学習コスト | SQLの知識が中心 | SQLとORMの知識が必要 |
| 複雑なSQL | 直接記述しやすい | ORMで表現、必要に応じてSQLも使用可能 |
メリット① コードの可読性と保守性
例えば、図書館システムで書籍IDが1の書籍を取得する場合を比較します。
前提としてbookクラスは定義されています。
from flask_sqlalchemy import SQLAlchemy

db = SQLAlchemy()

class Book(db.Model):
    __tablename__ = "books"

    id = db.Column(db.Integer, primary_key=True)
    title = db.Column(db.String)
    author = db.Column(db.String)
SQLを直接使用する場合
import sqlite3

conn = sqlite3.connect("library.db")

cursor = conn.execute(
    "SELECT id, title, author FROM books WHERE id = ?",
    (1,)
)

book = cursor.fetchone()

conn.close()
SQLAlchemyを使用する場合
Flaskアプリでデータベース接続設定と db.init_app(app) が済んでいれば、アプリケーションコンテキスト内で次のように取得できます。
book = db.session.get(Book, 1)Flask-SQLAlchemyでは、データベースの接続設定やモデル定義を事前に行うことで、SQL文を直接記述せずにデータを取得できます。また、取得結果はタプルではなくBookクラスのインスタンスとなるため、book.title や book.author のように属性を使用してアクセスできます。
if book is not None:
    print(book.title)
    print(book.author)
例のようにbookオブジェクトのtitleとauthorを参照してます。
メリット② データベースの種類に依存しにくい
SQLAlchemyは、SQLite、MySQL、PostgreSQLなど、複数のデータベースに対応しています。例えば、学習時にはSQLiteを使用し、本番環境ではPostgreSQLを使用する構成も考えられます。データベースの接続設定を変更することで、多くの基本的なデータ操作を共通のコードで実行できます。
ただし、データ型やSQL関数、制約などにはデータベース固有の違いがあるため、接続先を変更するだけで必ず完全に移行できるわけではありません。
メリット③ トランザクションを管理しやすい
図書館システムで書籍を貸し出す場合、次のような処理が必要になることがあります。
- 貸出履歴を登録する
- 書籍の貸出状態を変更する
これらは一つのまとまった処理として実行する必要があります。一方だけ成功すると、書籍の状態と貸出履歴が一致しなくなる可能性があります。SQLAlchemyのSessionを利用すると、複数の変更をまとめてcommit()したり、失敗した場合にrollback()したりできます。これにより、データの整合性を維持する処理を実装しやすくなります。
メリット④ テーブル同士の関係を表現できる
図書館システムには、書籍、会員、貸出履歴など、複数のテーブルが存在します。例えば、貸出履歴は書籍IDと会員IDを持ち、それぞれのテーブルを外部キーで参照する構造が考えられます。SQLAlchemyでは、外部キーやrelationship()を使用して、テーブル間の関係をPythonのモデルとして表現できます。これにより、関連するデータの取得や操作を整理しやすくなります。
3. SQLAlchemyを使用しない場合のメリットとデメリット
SQLAlchemyには多くのメリットがありますが、すべてのアプリケーションで導入が必要というわけではありません。
SQLを直接使用するメリット
SQLを直接使用する方法には、次のような利点があります。
- 実行されるSQLを直接把握しやすい
- ORMライブラリを追加する必要がない
- SQLの学習やデータベースの仕組みを理解するのに適している
- 特定のデータベースに最適化したSQLを記述しやすい
例えば、単純な書籍検索だけを行う小規模なアプリケーションであれば、Python標準のsqlite3でも十分に実装できます。
SQLを直接使用するデメリット
一方、機能が増えると、SQL文や検索結果の変換、接続処理などを管理するコードも増加する傾向があります。また、同じ検索処理を複数のルーティングに記述すると、テーブル構造が変更された際に、複数箇所を修正する必要が生じます。
ただし、SQLを直接使用すること自体が危険というわけではありません。プレースホルダーを使用して入力値を適切に渡すことで、SQLインジェクションを防ぐこともできます。
SQLAlchemyのメリットは、SQLを使わないことではなく、データベース操作の仕組みを統一し、複雑なアプリケーションを管理しやすくすることにあります。
4. Flaskアプリケーションの構造
SQLAlchemyを導入する場合、データベースに関する処理をmodels.pyやextensions.pyなどに分離する構成が一般的です。図書館システムでは、次のような構造が考えられます。
図書館システムのディレクトリ構成例
図書館システムのディレクトリ構成例
library_app/

   run.py — アプリケーションの起動

   app/

      __init__.py — アプリ生成・初期設定

      extensions.py — SQLAlchemyの初期化オブジェクト(追加)

      models.py — テーブル構造・モデル定義(追加)

      routes.py — ルーティング・ビュー関数

      forms.py — 入力項目・バリデーション

   templates/

      base.html — 共通レイアウト

      book_create.html — 書籍登録画面

      books.html — 書籍一覧画面

instance/ — SQLiteデータベースの保存先この構造では、前回学習したBlueprintやforms.pyの役割は変わりません。
新しく加わるのは、データベースを管理するmodels.pyとextensions.pyです。
| ファイル | 主な役割 |
|---|---|
run.py | アプリケーションの起動 |
__init__.py | create_app()によるアプリ生成と各機能の登録 |
extensions.py | SQLAlchemyのインスタンスを定義 |
models.py | テーブルのカラム、制約、関連を定義 |
routes.py | リクエストを受け取り、DB操作や画面遷移を制御 |
forms.py | 入力値の検証 |
| Jinja2 | データの表示、フォームやエラーメッセージの描画 |
なお、models.pyというファイル名やファイル分割はFlaskの必須ルールではありません。アプリケーションの規模に応じて構造を変更できます。
5. SQLAlchemy・ルーティング・forms.py・Jinja2の関係
図書館システムで書籍を登録する場合、各ファイルは次のように連携します。
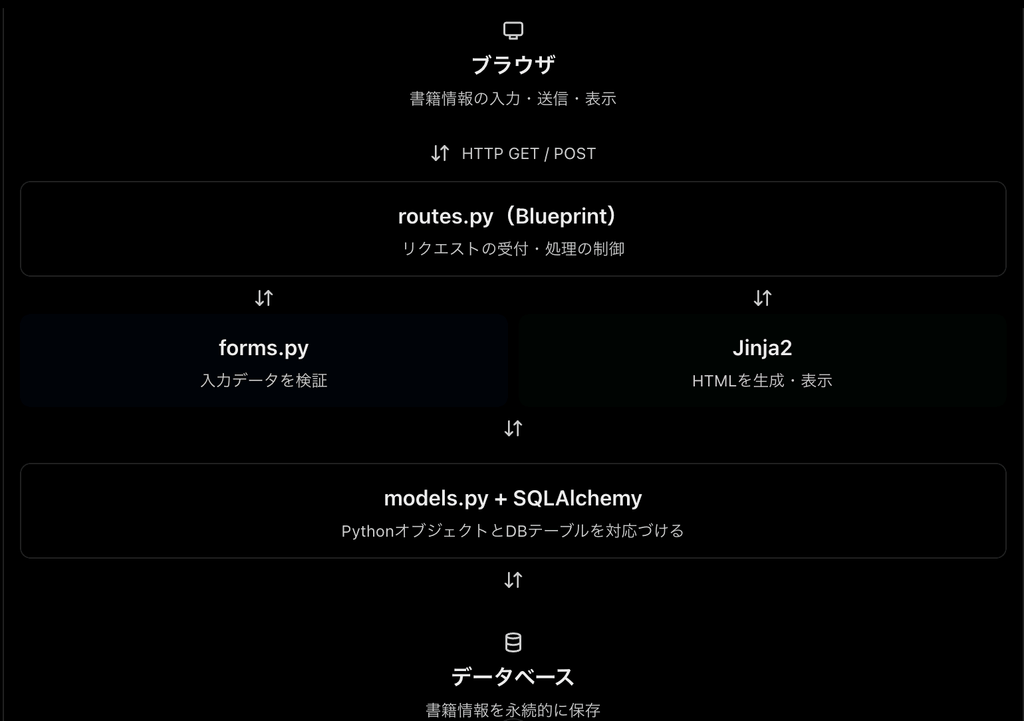
例えば、書籍登録処理は次の順序で実行されます。
routes.pyが書籍登録ページへのアクセスを受け取ります。forms.pyで定義したフォームをJinja2に渡して表示します。- ユーザーが書籍タイトルや著者名を入力して送信します。
forms.pyが送信されたデータを検証します。- 正常であれば
routes.pyがBookモデルのインスタンスを作成します。 - SQLAlchemyがデータベースに書籍情報を保存します。
- 保存後、
routes.pyが書籍一覧画面にリダイレクトします。
このように、forms.pyが入力内容を検証し、models.pyがデータベース上の構造を定義し、routes.pyが全体の処理を制御するという関係になります。
6. SQLAlchemyの初期設定
FlaskでSQLAlchemyを使用する場合、一般的にはFlask-SQLAlchemyという拡張ライブラリを利用します。Flask-SQLAlchemyは、SQLAlchemyをFlaskアプリケーションで使いやすくするためのライブラリです。
① ライブラリのインストール
仮想環境を有効にした状態で、次のコマンドを実行します。
python -m pip install Flask-SQLAlchemy前回の記事で使用したFlask-WTFも組み合わせる場合は、次のように一緒にインストールできます。
python -m pip install Flask-SQLAlchemy Flask-WTF② extensions.pyの作成
最初にSQLAlchemyのインスタンスを作成します。
app/extensions.py
from flask_sqlalchemy import SQLAlchemy

db = SQLAlchemy()
ここではSQLAlchemy()を実行していますが、まだデータベースへの接続設定は行っていません。実際の接続設定やFlaskアプリとの関連付けは、次で紹介する __init__.py で行います。このようにFlaskアプリケーションとSQLAlchemyの初期化を分離することで、create_app()を使用する構成にも対応できます。
③ Flaskアプリケーションとの連携
続いてconfig.pyにデータベースの接続設定を記述します。先ほど作成したextensions.pyをdbとしてインポートしてSQLAlchemyのインスタンスを読み込みます。
config.py(プロジェクト直下)を作成
config.pyは、Flaskアプリケーションで使用する各種設定を一元管理するファイルです。データベースの接続先(SQLALCHEMY_DATABASE_URI)や秘密鍵(SECRET_KEY)などを定義し、__init__.pyから読み込んで利用します。設定とアプリケーションの処理を分離することで、保守性や管理のしやすさが向上します。
import os

class Config:
    SECRET_KEY = os.environ["SECRET_KEY"]

    SQLALCHEMY_DATABASE_URI = "sqlite:///library.db"

    SQLALCHEMY_TRACK_MODIFICATIONS = False
各設定の役割は次のとおりです。
| 設定 | 役割 |
|---|---|
SECRET_KEY | セッションやCSRF保護に使用する秘密鍵 |
SQLALCHEMY_DATABASE_URI | 接続するデータベースの指定 |
SQLALCHEMY_TRACK_MODIFICATIONS | SQLAlchemyの変更追跡機能を無効化 |
SECRET_KEYは環境変数から取得します。設定されていない場合はKeyErrorになるため、事前に環境変数を用意してください。環境変数の取得は Flaskでのフォーム処理の基礎 にて説明してます。
SQLALCHEMY_DATABASE_URI = "sqlite:///library.db"は使用するデータベースをSQLiteの library.db に設定します。
app/init.py
from flask import Flask
from .extensions import db

def create_app():
    app = Flask(__name__)

    # config.pyから設定を読み込む
    app.config.from_object("config.Config")

    # SQLAlchemyを初期化
    db.init_app(app)

    # モデルを読み込む
    from . import models

    # Blueprintを登録
    from .routes import main
    app.register_blueprint(main)

    return app
app.config.from_object(“config.Config”) にてconfigファイルを読み込みSQLAlchemyとFlaskアプリケーションを関連付け、設定を適用します。
④ run.pyの作成
run.py
from app import create_app

app = create_app()

if __name__ == "__main__":
    app.run(debug=True)
ここでのdebug=Trueは学習用です。本番環境ではデバッグモードを無効にしてください。これでFlaskとSQLAlchemyを連携するための基本設定が整いました。
7. モデル定義の基本
SQLAlchemyでは、データベースのテーブル構造をPythonのクラスとして定義します。
このクラスを**モデル(Model)**と呼びます。
例えば、図書館システムに書籍情報を管理するbooksテーブルを作成するとします。
booksテーブルの構造
| カラム名 | データ型 | 制約 | 説明 |
|---|---|---|---|
| id | INTEGER | PRIMARY KEY | 書籍ID |
| title | VARCHAR(100) | NOT NULL | 書籍タイトル |
| author | VARCHAR(100) | NOT NULL | 著者名 |
| isbn | VARCHAR(13) | UNIQUE | ISBN |
| is_available | BOOLEAN | NOT NULL | 貸出可能かどうか |
このテーブルをSQLAlchemyで定義すると、次のようになります。
app/models.py
from .extensions import db

class Book(db.Model):
    __tablename__ = "books"

    id = db.Column(
        db.Integer,
        primary_key=True
    )

    title = db.Column(
        db.String(100),
        nullable=False
    )

    author = db.Column(
        db.String(100),
        nullable=False
    )

    isbn = db.Column(
        db.String(13),
        unique=True,
        nullable=True
    )

    is_available = db.Column(
        db.Boolean,
        nullable=False,
        default=True
    )
このコードでは、Bookクラスをデータベースのbooksテーブルに対応づけています。db.Modelを継承することで、SQLAlchemyのモデルとして利用できます。
モデルで使用する主な構文
| 構文 | 説明 |
|---|---|
db.Model | SQLAlchemyのモデル基底クラス |
__tablename__ | テーブル名を指定 |
db.Column() | カラムを定義 |
db.Integer | 整数型 |
db.String(100) | 最大100文字の文字列型 |
db.Boolean | 真偽値型 |
primary_key=True | 主キーを設定 |
nullable=False | NULLを禁止 |
unique=True | 重複を禁止 |
default=True | デフォルト値を指定 |
モデル定義とSQLの関係
先ほどのモデルは、概念的には次のようなSQLのテーブル定義に対応します。
CREATE TABLE books (
    id INTEGER PRIMARY KEY,
    title VARCHAR(100) NOT NULL,
    author VARCHAR(100) NOT NULL,
    isbn VARCHAR(13) UNIQUE,
    is_available BOOLEAN NOT NULL
);
実際に生成されるSQLはデータベースの種類によって異なります。また、Pythonのdefault=TrueはSQLAlchemy側で適用するデフォルト値であり、必ずしもデータベースのDEFAULT制約として生成されるわけではありません。
既存のSQL知識は必要なのか
SQLAlchemyを使用しても、テーブル設計の知識は必要です。例えば、主キー、外部キー、NOT NULL制約、UNIQUE制約などは、SQLAlchemyでも重要な要素になります。
SQLAlchemyはデータベース設計を自動的に正しく行ってくれるものではなく、開発者が設計したテーブル構造をPythonのクラスで表現するための仕組みです。
8. データベースとテーブルの作成
モデルを定義しただけでは、データベースにテーブルは作成されません。初回にテーブルを作成するには、db.create_all()を実行します。まず、Flaskのシェルを起動します。起動ファイルがrun.pyだと以下の通り。
python -m flask --app run shellFlaskの起動ファイルがapp.py にFlaskアプリケーションが定義されていれば、次のようになります。
python -m flask --app app shell
つまり、--app の後ろには、Flaskアプリケーションを読み込む対象のモジュール名またはパッケージ名を指定します。続いてシェルが実行できる状態になったら以下のPythonコードをコマンドインタプリタで実行します。
from app.extensions import db

db.create_all()
これにより、モデルとして定義したテーブルが作成されます。
なぜapp_context()が必要になる場合があるのか
Flask-SQLAlchemyでは、データベースの操作にFlaskのアプリケーションコンテキストが必要です。コンテキストとは、現在使用しているFlaskアプリケーションの設定や関連情報を参照するための仕組みです。
flask shellでは通常、自動的にアプリケーションコンテキストが有効になります。一方、Flaskのシェルではない独立したPythonコードから操作する場合は、次のように明示的に設定します。
from app import create_app
from app.extensions import db

app = create_app()

with app.app_context():
    db.create_all()
これにより、SQLAlchemyはどのFlaskアプリケーションのデータベース設定を使用するか判断できます。
create_all()の注意点
db.create_all()は、存在しないテーブルを新しく作成するための処理です。既存テーブルのカラム構造を変更する機能ではありません。例えば、後からBookモデルにpublisherというカラムを追加しても、db.create_all()を再実行するだけでは既存のbooksテーブルは更新されません。
このような変更には、AlembicやFlask-Migrateなどのマイグレーションツールを使用します。開発中であっても、既存のデータベースを削除して作り直すと保存済みデータが失われるため、注意が必要です。
9. CRUD操作の基本
データベース操作の基本はCRUDです。
CRUDとは、次の4つの操作の頭文字を組み合わせた用語です。
| C Create 新規作成 書籍を登録 | R Read 読み取り 書籍を検索・表示 |
| U Update 更新 書籍情報を変更 | D Delete 削除 書籍を削除 |
ここでは先ほど定義したBookモデルを使用し、それぞれの操作を説明します。以下のコードはFlaskのリクエスト処理内、またはアプリケーションコンテキストが有効な環境で実行することを前提としています。
① Create:新規作成
書籍を新規登録するには、Bookクラスのインスタンスを作成します。
new_book = Book(
    title="Python入門",
    author="山田太郎",
    isbn="9784000000001"
)

db.session.add(new_book)
db.session.commit()
処理は次の順序で実行されます。
Book()で書籍オブジェクトを作成する。db.session.add()で保存対象として登録する。db.session.commit()で変更を確定する。
add()を実行しただけでは、データベースへの登録が確定したわけではありません。
commit()によってトランザクションが確定します。
② Read:読み取り
登録されている書籍を取得するには、select()を使用します。
すべての書籍を取得する場合
books = db.session.scalars(
    db.select(Book)
).all()
書籍タイトルで検索する場合
books = db.session.scalars(
    db.select(Book).where(
        Book.title == "Python入門"
    )
).all()
主キーで検索する場合
book = db.session.get(Book, 1)db.session.get(Book, 1)は、書籍IDが1のレコードを取得します。該当するレコードが存在しない場合はNoneを返します。
旧式のquery構文との違い
SQLAlchemyの古い教材では、次の記述が使われていることがあります。
books = Book.query.all()
book = Book.query.get(1)
これらは従来のクエリインターフェースです。
現在のFlask-SQLAlchemyでは、db.select()やdb.session.get()などの新しい形式を優先することが推奨されています。Flask-SQLAlchemy Documentation (3.1.x)
本記事では、新しい記述方法を使用します。
③ Update:更新
既存の書籍情報を変更する場合、まず該当する書籍を取得します。
book = db.session.get(Book, 1)

if book is not None:
    book.title = "Python実践入門"
    book.author = "山田太郎"

db.session.commit()SQLAlchemyでは、取得したオブジェクトの属性を変更してcommit()することで、データベースに変更を反映できます。
SQLのUPDATE文を直接記述する必要はありません。
④ Delete:削除
書籍を削除する場合は、db.session.delete()を使用します。
book = db.session.get(Book, 1)

if book is not None:
    db.session.delete(book)
db.session.commit()SQLのDELETE文を直接記述しなくても、対象の書籍を削除できます。
ただし、実際の図書館システムでは、貸出中の書籍や貸出履歴が存在する書籍を削除してよいか確認する必要があります。そのため、単純にレコードを削除するのではなく、削除を禁止したり、論理削除を採用したりする設計も考えられます。
CRUDとSQLの対応表
| 操作 | SQL | SQLAlchemy |
|---|---|---|
| 作成 | INSERT INTO | db.session.add() |
| 読取 | SELECT | db.select()・db.session.get() |
| 更新 | UPDATE | オブジェクトの属性変更 |
| 削除 | DELETE | db.session.delete() |
| 確定 | COMMIT | db.session.commit() |
SQLAlchemyを利用することで、基本的なデータベース操作をPythonのクラスやメソッドによって表現できます。
10. Blueprint・forms.py・SQLAlchemyを組み合わせる
ここまでは、SQLAlchemy単体でのデータベース操作を確認しました。実際のFlaskアプリケーションでは、これらの処理をルーティングやJinja2と組み合わせて使用します。
例えば、図書館システムに「書籍登録機能」と「書籍一覧機能」を実装する場合を考えます。
① forms.py:フォームの定義
まず、書籍登録用のフォームを定義します。
app/forms.py
from flask_wtf import FlaskForm
from wtforms import StringField, SubmitField
from wtforms.validators import DataRequired, Length

class BookForm(FlaskForm):
    title = StringField(
        "書籍タイトル",
        validators=[
            DataRequired(),
            Length(max=100)
        ]
    )

    author = StringField(
        "著者名",
        validators=[
            DataRequired(),
            Length(max=100)
        ]
    )

    submit = SubmitField("登録")
forms.pyでは、画面から入力する書籍タイトルと著者名を定義しています。
この時点では、データベースへの保存処理は実行しません。
② routes.py:ルーティングとデータベース操作
続いて、Blueprintのビュー関数を作成します。
app/routes.py
from flask import Blueprint, render_template, redirect, url_for
from .extensions import db
from .models import Book
from .forms import BookForm

main = Blueprint("main", __name__)

# 書籍一覧
@main.route("/books")
def books():
    book_list = db.session.scalars(
        db.select(Book).order_by(Book.id)
    ).all()

    return render_template(
        "books.html",
        books=book_list
    )


# 書籍登録
@main.route("/books/create", methods=["GET", "POST"])
def book_create():
    form = BookForm()

    if form.validate_on_submit():
        new_book = Book(
            title=form.title.data,
            author=form.author.data
        )

        db.session.add(new_book)
        db.session.commit()

        return redirect(url_for("main.books"))

    return render_template(
        "book_create.html",
        form=form
    )
このコードでは、BlueprintとSQLAlchemyがそれぞれ異なる役割を担当しています。
@main.route():アクセスするURLとビュー関数を対応づけるBookForm():入力フォームを生成するvalidate_on_submit():送信内容を検証するBook():書籍オブジェクトを作成するdb.session.add():保存対象として登録するdb.session.commit():データベースへの変更を確定するrender_template():Jinja2でHTMLを生成するredirect():登録後に書籍一覧画面へ移動する
このように、routes.pyは処理全体を制御しますが、フォームの細かな検証やデータベースのテーブル定義までは担当しません。
③ Jinja2:書籍登録フォーム
templates/book_create.html
<h1>書籍登録</h1>

<form method="POST">
    {{ form.hidden_tag() }}

    <p>
        {{ form.title.label }}
        {{ form.title() }}
    </p>

    {% for error in form.title.errors %}
        <p>{{ error }}</p>
    {% endfor %}

    <p>
        {{ form.author.label }}
        {{ form.author() }}
    </p>

    {% for error in form.author.errors %}
        <p>{{ error }}</p>
    {% endfor %}

    {{ form.submit() }}
</form>
Jinja2では、routes.pyから渡されたformオブジェクトを使用してフォームを表示します。
前回学習したforms.pyと同じ仕組みです。
④ Jinja2:書籍一覧画面
templates/books.html
<h1>書籍一覧</h1>

<a href="{{ url_for('main.book_create') }}">
    新しい書籍を登録
</a>

<table border="1">
    <tr>
        <th>ID</th>
        <th>書籍タイトル</th>
        <th>著者名</th>
    </tr>

    {% for book in books %}
    <tr>
        <td>{{ book.id }}</td>
        <td>{{ book.title }}</td>
        <td>{{ book.author }}</td>
    </tr>
    {% endfor %}
</table>
routes.pyでは、SQLAlchemyを使用して書籍一覧を取得しました。
book_list = db.session.scalars(
    db.select(Book).order_by(Book.id)
).all()
このデータを次の処理でJinja2に渡しています。
return render_template(
    "books.html",
    books=book_list
)Jinja2は受け取ったbooksをループ処理し、書籍一覧のHTMLを生成します。この仕組みでは、Jinja2自体がSQLAlchemyを使ってデータベースを検索する必要はありません。データ取得はPython側、画面表示はJinja2側という役割分担になります。
⑤ 画面遷移とデータ処理の流れ
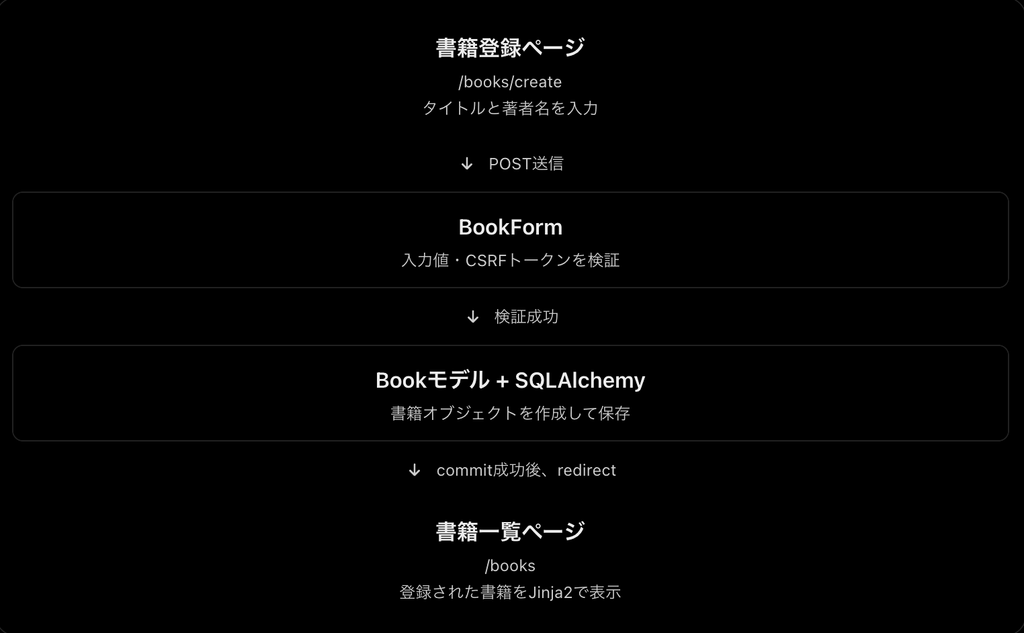
登録処理が成功した後にredirect()を実行する構造は、PRG(Post/Redirect/Get)パターンです。これにより、ブラウザの再読み込みによるフォームの二重送信を起こりにくくできます。ただし、通信の再試行などによる重複登録まで完全に防げるわけではありません。
なお、上記は学習用の最小構成です。本番環境では保存時の例外処理、認証・認可、入力値の重複チェックなども必要になります。
11. SQLAlchemyとセキュリティの関係
SQLAlchemyを導入するメリットの一つが、データベース操作に関するセキュリティ対策を実装しやすくなることです。ただし、SQLAlchemyを使用するだけですべてのセキュリティ問題が解決するわけではありません。
| セキュリティ項目 | 目的 | 主な担当 |
|---|---|---|
| SQLインジェクション対策 | 不正なSQLの実行を防ぐ | SQLAlchemy・DBアクセス処理 |
| 入力値の検証 | 不適切な値の登録を防ぐ | forms.py |
| CSRF対策 | 意図しない操作を防ぐ | Flask-WTF |
| XSS対策 | 不正なスクリプトの実行を防ぐ | Jinja2・表示処理 |
| データの整合性 | 不正なデータや矛盾を防ぐ | models.py・DB制約 |
| 認証・認可 | 操作権限を制限する | routes.py・認証機構 |
| DB接続情報の保護 | パスワードなどの漏えいを防ぐ | 環境変数・設定管理 |
SQLインジェクション対策
SQLインジェクションは、外部から入力されたデータを悪用して、意図しないSQLを実行させる攻撃です。例えば、図書館システムの書籍検索機能において、利用者が入力した文字列をSQL文に直接連結すると危険です。
危険な例
title = request.form["title"]

sql = f"SELECT * FROM books WHERE title = '{title}'"
この記述では、入力された文字列がSQL文の一部として組み込まれます。そのため、入力内容によってSQLの意味が変化する可能性があります。
SQLAlchemyを使用した例
title = request.form["title"]

books = db.session.scalars(
    db.select(Book).where(Book.title == title)
).all()
この記述では、SQLAlchemyが入力値をSQLのパラメータとして扱うため、SQLインジェクションのリスクを軽減できます。
なお、生のSQLでもプレースホルダーを適切に使用すれば同様の対策が可能です。反対に、SQLAlchemyを使用していても、不適切な文字列結合によってSQLを組み立てれば危険です。
データの整合性
SQLAlchemyでは、モデルに制約を設定することで、データベース内の情報が不適切な状態になることを防ぎやすくなります。
例えば、次の定義ではISBNの重複を禁止しています。
isbn = db.Column(
    db.String(13),
    unique=True
)このような制約に違反するデータを登録しようとすると、データベースでエラーが発生します。また、nullable=Falseを設定すると、NULL値の登録を禁止できます。ただし、nullable=Falseだけでは空文字列の登録まで禁止できるわけではありません。そのため、フォームでの入力検証とデータベースの制約を組み合わせることが重要です。
トランザクションとrollback()
データベースへの保存処理でエラーが発生した場合、トランザクションを取り消す必要があります。例えば、ISBNが重複した書籍を登録すると、UNIQUE制約によってエラーが発生します。その場合は、次のように処理できます。
from sqlalchemy.exc import IntegrityError

new_book = Book(
    title="Python入門",
    author="山田太郎",
    isbn="9784000000001"
)

try:
    db.session.add(new_book)
    db.session.commit()

except IntegrityError:
    db.session.rollback()
    print("登録できませんでした")
rollback()によって、失敗したトランザクションを取り消します。これにより、同じSessionを使った後続の処理を適切に継続できる状態へ戻せます。実際のアプリケーションでは、エラーの内容をログに記録し、利用者には適切なメッセージを表示する設計が必要です。
認証・認可との関係
SQLAlchemyは、データベース操作を行うためのライブラリです。そのため、誰が書籍情報を変更できるかという権限管理までは自動で行いません。例えば、図書館システムでは、一般利用者は書籍を検索できますが、書籍の登録や削除は職員だけに許可する設計が考えられます。
このようなアクセス制御は、認証・認可機構を使って実装する必要があります。また、書籍の削除処理をHTTPのGETで実行することは避け、POSTなどの適切なHTTPメソッドとCSRF保護を利用することが重要です。
12. テーブルの変更とマイグレーション
アプリケーション開発では、最初に作成したテーブル構造を後から変更することがあります。例えば、図書館システムの書籍テーブルに「出版社」という項目を追加する場合を考えます。
models.pyに次のカラムを追加します。
publisher = db.Column(
    db.String(100),
    nullable=True
)しかし、モデルにカラムを追加しただけでは、既存のデータベースにpublisherカラムは作成されません。また、db.create_all()を再実行しても、既存テーブルの構造は変更されません。このような変更を管理する仕組みが**マイグレーション(Migration)**です。
Flask-Migrateの利用
Flaskでは、SQLAlchemyのテーブル変更を管理するためにFlask-Migrateを使用できます。
python -m pip install Flask-MigrateFlask-Migrateを設定すると、通常は次のコマンドを使用します。
| コマンド | 役割 |
|---|---|
flask db init | マイグレーション環境を初期化する |
flask db migrate -m "Add publisher" | モデルの変更から移行スクリプトを生成する |
flask db upgrade | マイグレーションを適用する |
これらを利用することで、保存済みのデータを維持しながらテーブル構造を変更しやすくなります。ただし、マイグレーションが生成した内容は必ず確認する必要があります。すべての変更を自動的かつ安全に判断してくれるわけではありません。
13. BlueprintとSQLAlchemyによる機能別管理
図書館システムの規模が大きくなると、書籍管理だけでなく、会員管理や貸出管理などの機能も必要になります。その場合は、Blueprintを使用して機能ごとにファイルを分割する構成が考えられます。
app/
├── __init__.py
├── extensions.py
│
├── books/
│   ├── __init__.py
│   ├── routes.py
│   ├── forms.py
│   └── models.py
│
├── members/
│   ├── __init__.py
│   ├── routes.py
│   ├── forms.py
│   └── models.py
│
├── loans/
│   ├── __init__.py
│   ├── routes.py
│   ├── forms.py
│   └── models.py
│
└── templates/
    ├── books/
    │   └── list.html
    ├── members/
    │   └── list.html
    └── loans/
└── list.htmlこの構成では、各機能がそれぞれのルーティング、フォーム、モデルを管理します。ただし、SQLAlchemyのインスタンスはextensions.pyに共通で定義し、各モデルから参照する形にします。
テーブル同士の関係
例えば、書籍・会員・貸出履歴は次のような関係になります。
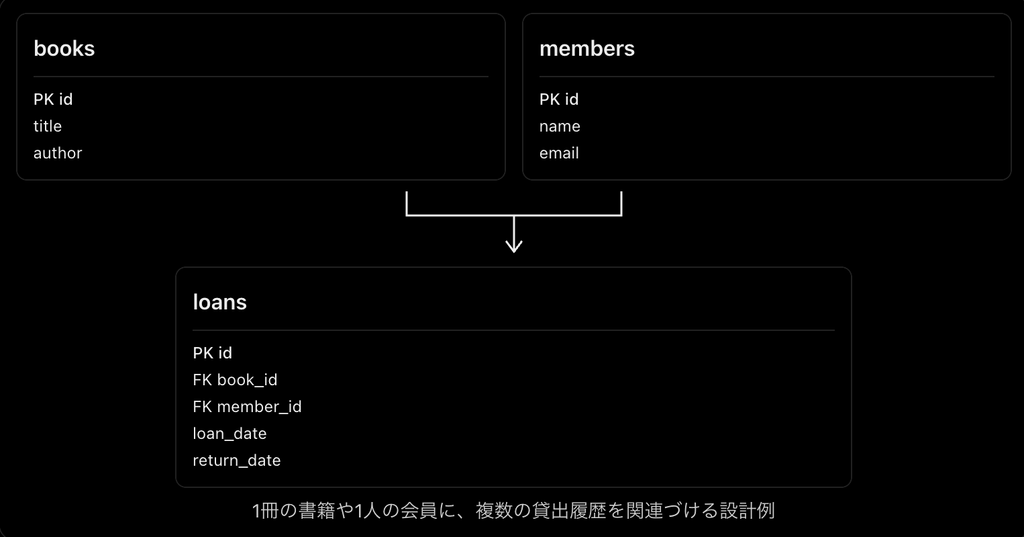
1冊の書籍や1人の会員に、複数の貸出履歴を関連づける設計例
SQLAlchemyでは、外部キーやrelationship()を使用して、これらの関係をモデルとして表現できます。
例えば、貸出履歴モデルに次のようなカラムを定義できます。
class Loan(db.Model):
    __tablename__ = "loans"

    id = db.Column(
        db.Integer,
        primary_key=True
    )

    book_id = db.Column(
        db.Integer,
        db.ForeignKey("books.id"),
        nullable=False
    )

    member_id = db.Column(
        db.Integer,
        db.ForeignKey("members.id"),
        nullable=False
    )
このコードは外部キーの基本構造を示したものです。実際に使用する場合は、Memberモデルや貸出日・返却日なども定義する必要があります。
SQLAlchemyは、複数テーブルのJOINや関連データの取得にも対応しているため、アプリケーションの機能が増えた場合にも活用できます。
まとめ
今回は、FlaskにおけるSQLAlchemyの役割と、データベース連携の基本について学習しました。
SQLAlchemyは、Pythonのクラスとデータベースのテーブルを対応づけるORM機能を提供し、SQLを直接記述する場合と比べて、データ操作の可読性や保守性を高められます。また、モデル定義やCRUD操作、トランザクション管理を共通の仕組みで扱うことができます。
Flaskアプリケーションでは、models.pyがテーブル構造、forms.pyが入力値の検証、routes.pyが処理の制御、Jinja2が画面表示を担当します。さらにBlueprintを組み合わせることで、機能ごとにファイルを整理し、拡張性の高いアプリケーションを構築できます。
SQLAlchemyはSQLインジェクション対策やデータの整合性確保にも役立ちますが、適切な入力検証や認証・認可、データベース設計も必要です。